Blog
RAG, GraphRAG o algo más: cómo elegir sin complicarlo todo
RAG no siempre necesita un grafo y no toda pregunta necesita RAG. Una guía práctica para elegir según los datos, las preguntas y el coste que podemos asumir.
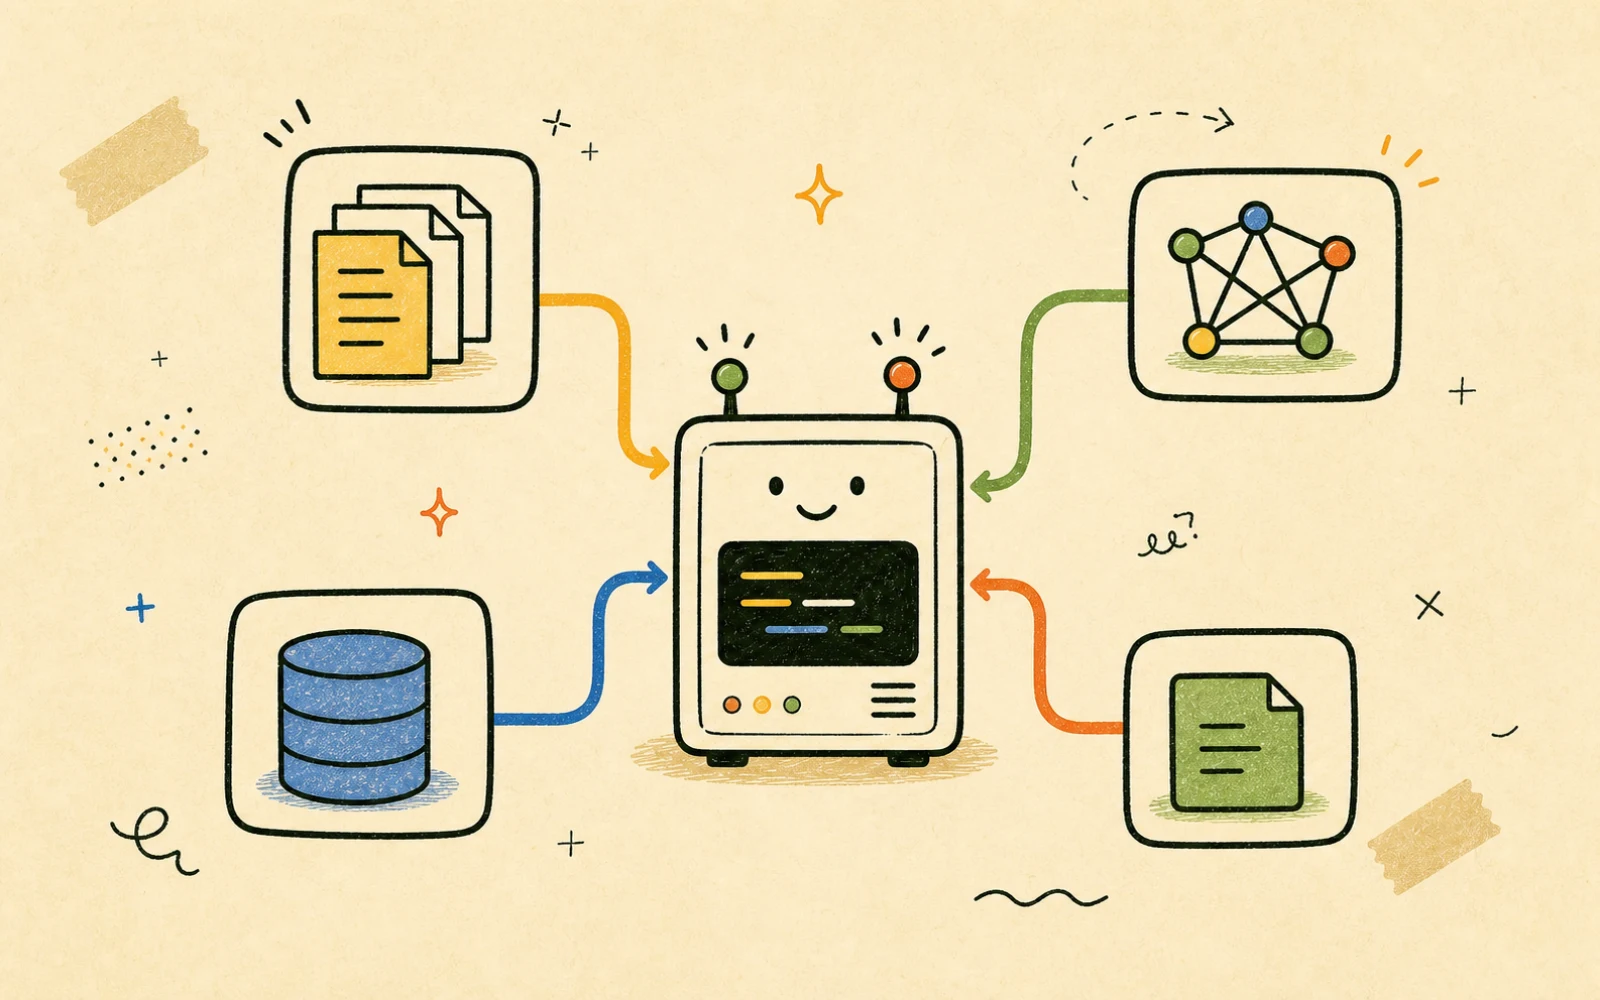
La forma de los datos y de la pregunta debería decidir la arquitectura, no el nombre de la técnica.
En muchas conversaciones sobre productos con IA aparece la misma progresión. Primero conectamos un modelo a varios documentos. Después alguien dice que necesitamos RAG. Poco más tarde surge GraphRAG, normalmente acompañado de un diagrama lleno de nodos, y la solución empieza a crecer antes de haber medido si la búsqueda inicial funcionaba mal.
Yo prefiero empezar por una pregunta menos interesante pero bastante más útil: ¿qué información necesita la respuesta y dónde vive realmente?
Si la respuesta está en 1 fragmento de 1 documento, RAG convencional suele ser suficiente. Si hay que reconstruir relaciones repartidas por cientos de documentos o entender los temas de toda una colección, un grafo puede ayudar. Si el dato ya vive en PostgreSQL, probablemente quiero consultar PostgreSQL. Y si todo el material relevante cabe cómodamente en la ventana de contexto, quizá no necesito ningún índice.
GraphRAG no es la siguiente versión de RAG. Es otra forma de construir contexto para otra clase de preguntas.
El ejemplo que usaré
Imaginemos un grupo de restaurantes que acumula 4 tipos de información:
- fichas de recetas, alérgenos y procedimientos de sala y cocina;
- reseñas, reclamaciones y partes escritos por los responsables de cada turno;
- facturas, catálogos e incidencias de proveedores;
- ventas, reservas y stock en una base de datos.
Queremos construir un asistente interno. Estas 4 preguntas parecen similares porque están escritas en lenguaje natural, pero no piden el mismo trabajo:
- ¿Cómo debemos preparar la cocina para un comensal con alergia al sésamo? La respuesta está en un procedimiento concreto.
- ¿Qué proveedores, platos y locales aparecen repetidamente en las reclamaciones por platos no disponibles? Hay que conectar entidades y hechos dispersos.
- ¿Cuántos comensales cenaron ayer en los locales del centro y cuál fue el gasto medio? Necesitamos un cálculo exacto sobre datos actuales y estructurados.
- Compara estas 6 propuestas de proveedores que acabo de adjuntar. El conjunto de documentos es pequeño, temporal y cabe en contexto.
Yo resolvería cada una de una manera distinta. Intentar que el mismo vector store conteste a las 4 es una forma excelente de fabricar una demo convincente y un producto poco fiable.
Qué hace RAG en realidad
El trabajo que introdujo RAG combinaba la memoria paramétrica de un modelo con una memoria externa recuperable. En una aplicación actual, el nombre suele describir un pipeline más general:
documentos -> fragmentos -> índice -> recuperación -> contexto -> respuestaDurante la ingesta dividimos los documentos en fragmentos, guardamos metadatos y creamos algún índice. Cuando llega una pregunta, recuperamos los fragmentos más prometedores y se los pasamos al modelo junto con instrucciones para responder y citar las fuentes.
El índice no tiene por qué ser exclusivamente vectorial. Las embeddings funcionan bien cuando la pregunta y el texto comparten significado pero no palabras. La búsqueda léxica, como BM25, suele ser mejor para identificadores, nombres de errores, versiones y términos exactos. En la práctica me gusta empezar con búsqueda híbrida, aplicar filtros de metadatos y, cuando hace falta, usar un reranker antes de llenar el contexto.
Para la pregunta sobre el sésamo, RAG encaja muy bien. El usuario quizá escribe “evitar que una alergia llegue al plato” mientras el manual habla de “protocolo de alérgenos y contaminación cruzada”. La búsqueda semántica puede salvar esa diferencia de vocabulario y devolver la sección correcta.
Preguntas y respuestas posibles con RAG
Estas respuestas son inventadas, pero muestran la forma que esperaría de un RAG sobre los documentos del restaurante: breve, concreta y con una fuente que podamos abrir.
| Pregunta | Respuesta potencial |
|---|---|
| ¿Qué hago si un comensal avisa de una alergia al sésamo? | Aplica el protocolo AL-04, avisa al responsable de cocina y registra la alerta en la reserva. [Manual de alérgenos, p. 3] |
| ¿La tarta de la casa contiene frutos secos? | Sí. La ficha incluye almendra y advierte de posible contaminación cruzada. [Ficha REC-31] |
| ¿Cuál es el procedimiento si una cámara frigorífica supera su límite? | Aísla el producto afectado y registra temperatura y hora antes de decidir si se descarta. [Procedimiento FRÍO-02] |
En RAG, los documentos siguen siendo la fuente principal. El índice solo organiza fragmentos y metadatos para recuperar la evidencia más útil.
Cuándo elegiría RAG convencional
RAG es un buen punto de partida cuando:
- la respuesta suele estar contenida en unos pocos fragmentos;
- la colección de documentos cambia y queremos actualizar conocimiento sin volver a entrenar el modelo;
- importa enseñar la fuente original;
- las preguntas son locales: una política, un procedimiento, una especificación o un caso concreto;
- podemos filtrar por permisos, producto, versión, idioma o fecha antes de recuperar texto.
Documentación de producto, bases de conocimiento, manuales, políticas internas y soporte suelen empezar aquí.
Por qué falla un RAG sencillo
La parte generativa recibe casi toda la atención, pero muchos fallos ocurren antes. Si no recuperamos la evidencia, el modelo no puede utilizarla.
Un fragmento puede decir “el límite aumenta a 200” sin conservar el nombre del plan, la versión o la fecha que estaban 2 páginas antes. Un embedding puede acercar 10 fragmentos parecidos y dejar fuera el único que contiene una excepción. Una búsqueda semántica puede tratar un identificador exacto como ruido. Y un top_k = 5 arbitrario puede ser demasiado pequeño para una pregunta comparativa y demasiado grande para una pregunta sencilla.
Antes de construir un grafo probaría, en este orden:
- conservar títulos, jerarquía, fecha, versión y permisos en los metadatos;
- ajustar cómo se dividen los documentos según su estructura, no solo cada cierto número de tokens;
- combinar búsqueda semántica y léxica;
- reescribir preguntas ambiguas, aplicar filtros y rerankear resultados;
- añadir contexto del documento a cada fragmento;
- medir la recuperación con preguntas reales.
El Contextual Retrieval de Anthropic es un ejemplo útil del punto 5: añade a cada fragmento una pequeña explicación de su lugar dentro del documento antes de construir los índices semántico y léxico. No convierte RAG en GraphRAG. Sencillamente evita perder información importante al cortar el documento.
Muchas veces el salto de calidad está ahí, en arreglar la representación y la recuperación, no en cambiar toda la arquitectura.
Qué añade GraphRAG
RAG convencional busca fragmentos parecidos a la pregunta. Eso funciona para preguntas locales, pero tiene dificultades con preguntas globales como “¿qué patrones aparecen en estos 3 años de reclamaciones y partes de turno?”. Ningún fragmento aislado contiene la respuesta porque la respuesta es una propiedad del conjunto.
El enfoque de GraphRAG publicado por Microsoft Research construye primero una representación intermedia. De forma simplificada:
documentos
  -> entidades + relaciones + afirmaciones
  -> comunidades de entidades relacionadas
  -> resúmenes por comunidad
  -> búsqueda local, global o mixta
  -> respuesta
Esto permite 2 clases de consulta especialmente interesantes:
- Local: empezar en una entidad y recorrer sus vecinos. Por ejemplo, “¿qué platos, proveedores y locales están conectados con los problemas de disponibilidad de este ingrediente?”.
- Global: combinar resúmenes de comunidades para contestar algo sobre toda la colección. Por ejemplo, “¿qué patrones operativos se repiten en las reclamaciones de los clientes?”.
Preguntas y respuestas posibles con GraphRAG
Aquí la respuesta no sale de 1 fragmento. Se construye conectando reclamaciones, partes de turno, platos, ingredientes, proveedores y locales. Los números siguen siendo ficticios.
| Pregunta | Respuesta potencial |
|---|---|
| ¿Qué conecta las reclamaciones por platos no disponibles? | 9 de 14 reclamaciones afectan a platos que comparten proveedor de verduras y se concentran en los locales Centro y Norte. |
| ¿Qué patrón se repite los viernes por la noche? | Las entregas tardías del viernes aparecen conectadas con falta de ingredientes, cambios de carta y más reclamaciones durante la cena. |
| ¿Qué pasaría si dejamos de trabajar con este proveedor? | 6 platos de 3 locales dependen de sus productos, y 2 no tienen un proveedor alternativo registrado. |
GraphRAG convierte la información de los documentos en entidades, relaciones y comunidades, conservando siempre el vínculo con las fuentes.
Microsoft también mantiene DRIFT Search, que mezcla información de comunidades con búsquedas locales y preguntas de seguimiento. La distinción importa más que los nombres: a veces necesitamos precisión alrededor de una entidad; otras veces necesitamos ampliar la mirada y sintetizar el conjunto.
Cuándo elegiría GraphRAG
Consideraría GraphRAG cuando se cumplen varias de estas condiciones:
- las relaciones entre entidades son parte de la respuesta, no solo metadatos decorativos;
- los hechos que necesitamos están repartidos entre muchos documentos;
- hacemos preguntas globales, de descubrimiento o de análisis temático;
- los usuarios quieren navegar desde una persona, local, proveedor, plato, ingrediente o evento hacia sus conexiones;
- la colección de documentos es lo bastante estable y valiosa como para amortizar una indexación más cara;
- podemos evaluar si las entidades, relaciones y resúmenes extraídos son buenos.
Investigación de fraude, inteligencia sobre amenazas, análisis de literatura, due diligence, redes de organizaciones y análisis operativo de una cadena de restauración son candidatos razonables. “Chat con 40 PDFs” no lo es automáticamente.
El grafo también inventa una nueva clase de problemas
GraphRAG no descubre la estructura verdadera escondida dentro de los documentos. Construye una interpretación de esa estructura.
Eso introduce decisiones difíciles. Restaurante Centro, Local Centro y Sucursal Centro pueden ser la misma entidad o 3 distintas. Una relación puede estar implícita, ser temporal o estar negada. El modelo puede omitirla o extraerla mal. Si un resumen de comunidad aplana una excepción importante, ese error se propaga a las respuestas globales.
También hay un coste operativo real. La indexación estándar de GraphRAG usa modelos para extraer entidades y relaciones, resumir descripciones y generar informes de comunidades. La propia documentación ofrece un método más rápido porque la extracción del grafo representa aproximadamente el 75% del coste de la indexación estándar. Cuando cambia la colección hay que decidir qué recalcular, cómo versionarla y cómo mantener permisos y trazabilidad a través de la estructura derivada.
Un grafo generado por un modelo tampoco debería convertirse silenciosamente en la fuente de verdad de la empresa. Yo conservaría siempre el camino desde cada entidad, relación y resumen hasta el texto original. El grafo sirve para encontrar y organizar evidencia; la evidencia sigue estando en las fuentes.
Si el dominio ya tiene relaciones explícitas y fiables, como proveedores, ingredientes, platos, locales y pedidos, preferiría partir de esas tablas y eventos antes que pedir a un modelo que las reconstruya desde prosa.
Cuándo usar otra cosa
La decisión útil no es únicamente RAG contra GraphRAG. Hay problemas cercanos que se resuelven mejor sin ninguno de los 2.
1. Contexto largo para un conjunto pequeño y temporal
Si el responsable de compras adjunta 6 propuestas de proveedores y quiere compararlas 1 vez, las pasaría directamente al modelo siempre que quepan con margen en su ventana de contexto. Evito una ingesta permanente, puedo conservar el orden y la estructura completos, y el sistema desaparece al terminar la petición.
Esto no significa meter siempre todos los documentos posibles. Más contexto aumenta coste y latencia, y la información relevante puede quedar enterrada. Pero para conjuntos pequeños, la simplicidad es difícil de superar.
2. SQL, APIs o herramientas para datos estructurados
“¿Cuántos comensales cenaron ayer en los locales del centro y cuál fue el gasto medio?” no es una pregunta de similitud semántica. Es un filtro y una agregación.
Haría que el modelo produjese una llamada a una herramienta validada o utilizase una capa semántica con métricas definidas. El resultado debería venir de la base de datos, no de fragmentos de dashboards indexados semanas atrás. Así obtenemos cifras actuales, operaciones deterministas y reglas de autorización que ya conoce el sistema.
RAG puede recuperar la definición interna de “comensal servido”; SQL calcula cuántos hubo y el gasto medio. Las arquitecturas se pueden componer.
Preguntas y respuestas posibles con SQL
En esta ruta no quiero una síntesis aproximada, sino el resultado exacto de una consulta autorizada sobre reservas, ventas o stock.
| Pregunta | Respuesta potencial |
|---|---|
| ¿Cuántos comensales cenaron ayer en los locales del centro? | 345 comensales, con un gasto medio de 31,40 €. |
| ¿Cuál fue la tasa de no presentación esta semana? | 23 de 412 reservas, un 5,6 %. |
| ¿Qué ingredientes están por debajo del stock mínimo? | 7 ingredientes. Los más urgentes son salmón, arroz y aceite de sésamo. |
En SQL, la información ya está organizada en tablas y relaciones explícitas. La base de datos aplica los filtros y calcula el resultado.
3. Búsqueda clásica cuando el usuario quiere encontrar, no generar
Para buscar la factura FAC-1842, una referencia concreta de proveedor o una frase legal, un índice invertido con filtros puede ser todo lo necesario. No añadiría un modelo si el resultado correcto es una lista de enlaces.
La búsqueda léxica también es un componente excelente dentro de RAG. “Clásico” no significa obsoleto.
4. Fine-tuning para comportamiento, no como base documental
El fine-tuning puede enseñar un formato, un tono, una taxonomía o una tarea repetitiva. No es mi primera elección para almacenar políticas que cambian cada semana, devolver citas o respetar permisos por documento. Actualizar ese conocimiento implica crear datos, entrenar y evaluar otra versión, y aun así no obtenemos una fuente verificable.
Podemos combinar ambos: fine-tuning para que el modelo responda con la estructura correcta y retrieval para proporcionarle los hechos actuales.
5. Un workflow o agente para preguntas de varios pasos
Algunas preguntas no necesitan un índice más sofisticado, sino un proceso. “Encuentra las reclamaciones por platos no disponibles del último trimestre, comprueba qué proveedores entregaron tarde esas semanas y revisa el stock actual de los ingredientes” exige buscar, consultar datos, seguir referencias y quizá corregir el plan.
Un workflow puede alternar búsqueda, SQL, APIs y lectura de documentos. Le pondría límites claros: herramientas permitidas, presupuesto, máximo de pasos y evidencia obligatoria. La autonomía sin observabilidad es otra manera de esconder errores.
Una tabla para decidir sin enamorarse de la arquitectura
| Necesidad dominante | Primera opción | Ejemplo | Principal coste o riesgo |
|---|---|---|---|
| Encontrar unos pocos pasajes relevantes | RAG híbrido | “¿Qué protocolo seguimos ante una alergia?” | Chunking y recuperación deficientes |
| Sintetizar patrones de toda una colección de documentos | GraphRAG o resúmenes jerárquicos | “¿Qué causas se repiten en las reclamaciones?” | Indexación, extracción y mantenimiento |
| Recorrer relaciones entre entidades | Grafo explícito o GraphRAG | “¿Qué platos y locales dependen de este proveedor?” | Resolución de entidades y relaciones falsas |
| Calcular sobre datos actuales | SQL, API o herramienta | “¿Cuántos comensales servimos ayer?” | Validación de consultas y permisos |
| Analizar pocos documentos 1 vez | Contexto largo | “Compara estas 6 propuestas de proveedores” | Coste, latencia y atención dispersa |
| Encontrar identificadores o texto exacto | Búsqueda léxica | “Busca FAC-1842” | Sin síntesis automática |
| Cambiar formato o comportamiento | Fine-tuning | “Clasifica tickets con esta taxonomía” | Dataset y regresiones del modelo |
| Combinar varias fuentes y pasos | Workflow o agente | “Investiga las reclamaciones y los retrasos de proveedores” | Latencia, coste y control del proceso |
No son casillas excluyentes. Un sistema serio puede usar un router sencillo: SQL para métricas, RAG para procedimientos y GraphRAG solo para preguntas globales. Lo que intento evitar es que todas las preguntas recorran el camino más caro.
Cómo lo construiría de menos a más
Empezaría con 30 o 50 preguntas reales, escritas por las personas que van a usar el sistema. Para cada una guardaría la respuesta esperada, las fuentes necesarias y el tipo de operación: lookup, comparación, agregación, relación o síntesis global.
Después construiría el baseline más pequeño que pueda funcionar. Para documentación sería búsqueda híbrida, buenos metadatos y citas. Mediría por separado:
- recuperación: ¿aparece la evidencia necesaria entre los resultados?;
- respuesta: ¿la afirmación está respaldada por esa evidencia?;
- citas: ¿apuntan al lugar que realmente demuestra la afirmación?;
- operación: latencia, coste, frescura y cumplimiento de permisos.
Si falla la recuperación local, arreglaría chunks, filtros, consulta y reranking. Si las preguntas globales siguen exigiendo leer docenas de resultados y juntarlos a mano, probaría resúmenes jerárquicos o GraphRAG sobre ese subconjunto. Si la respuesta debería ser una cifra exacta, sacaría esa ruta del retrieval y la conectaría a datos estructurados.
La evaluación también necesita negativos. El sistema debe saber decir “no tengo evidencia suficiente”, distinguir 2 productos con nombres parecidos y no utilizar un documento que el usuario no puede abrir. Una respuesta fluida con una fuente irrelevante sigue siendo un fallo.
La regla que intento recordar
RAG recupera evidencia local. GraphRAG organiza relaciones y ayuda a sintetizar estructura global. SQL y las APIs calculan sobre el estado real. El contexto largo elimina infraestructura cuando el problema es pequeño. El fine-tuning cambia cómo se comporta el modelo, no mantiene al día una biblioteca de hechos.
No elegiría GraphRAG porque RAG parezca poco avanzado. Lo elegiría cuando pueda señalar preguntas importantes que requieren relaciones o una visión global y demostrar que el baseline no las resuelve. Hasta entonces, un buen sistema de recuperación con metadatos, búsqueda híbrida, reranking, citas y una evaluación decente suele ser una base mucho más útil.
La arquitectura correcta no es la que contiene más IA. Es la que lleva la pregunta hasta la fuente adecuada con el menor número de oportunidades para equivocarse.
Thanks for reading, Hack the Planet!